虚拟细胞的瓶颈不在模型,而在给它看的那批数据
把细胞搬进计算机,模型架构不是最难的一环。真正卡住虚拟细胞的是训练数据:测的是 RNA 还是蛋白质,拍的是照片还是电影,是观察还是干预。三条判据决定一个虚拟细胞模型能不能用在临床上。
本节你将能
读完这一段,你能说清楚:为什么两个都叫「虚拟细胞」的模型,一个能进临床、一个只能发论文;拿到一篇虚拟细胞的新论文,该先看它的哪一段。
直觉模型:图纸、施工队和监控录像
把细胞想成一个工地。RNA 是图纸,告诉施工队下一步要造什么;蛋白质是施工队本身,真正搬砖、焊接、通电的是它们。转录组测序读的是图纸,蛋白质组学数的是施工队。
问题在于,图纸数量和施工队数量并不成正比。同一份图纸可以被反复使用,造出来的蛋白也能被随时拆掉。大量实测给出的相关性只有 0.4 上下——知道图纸,你对现场的判断仍然相当粗糙。
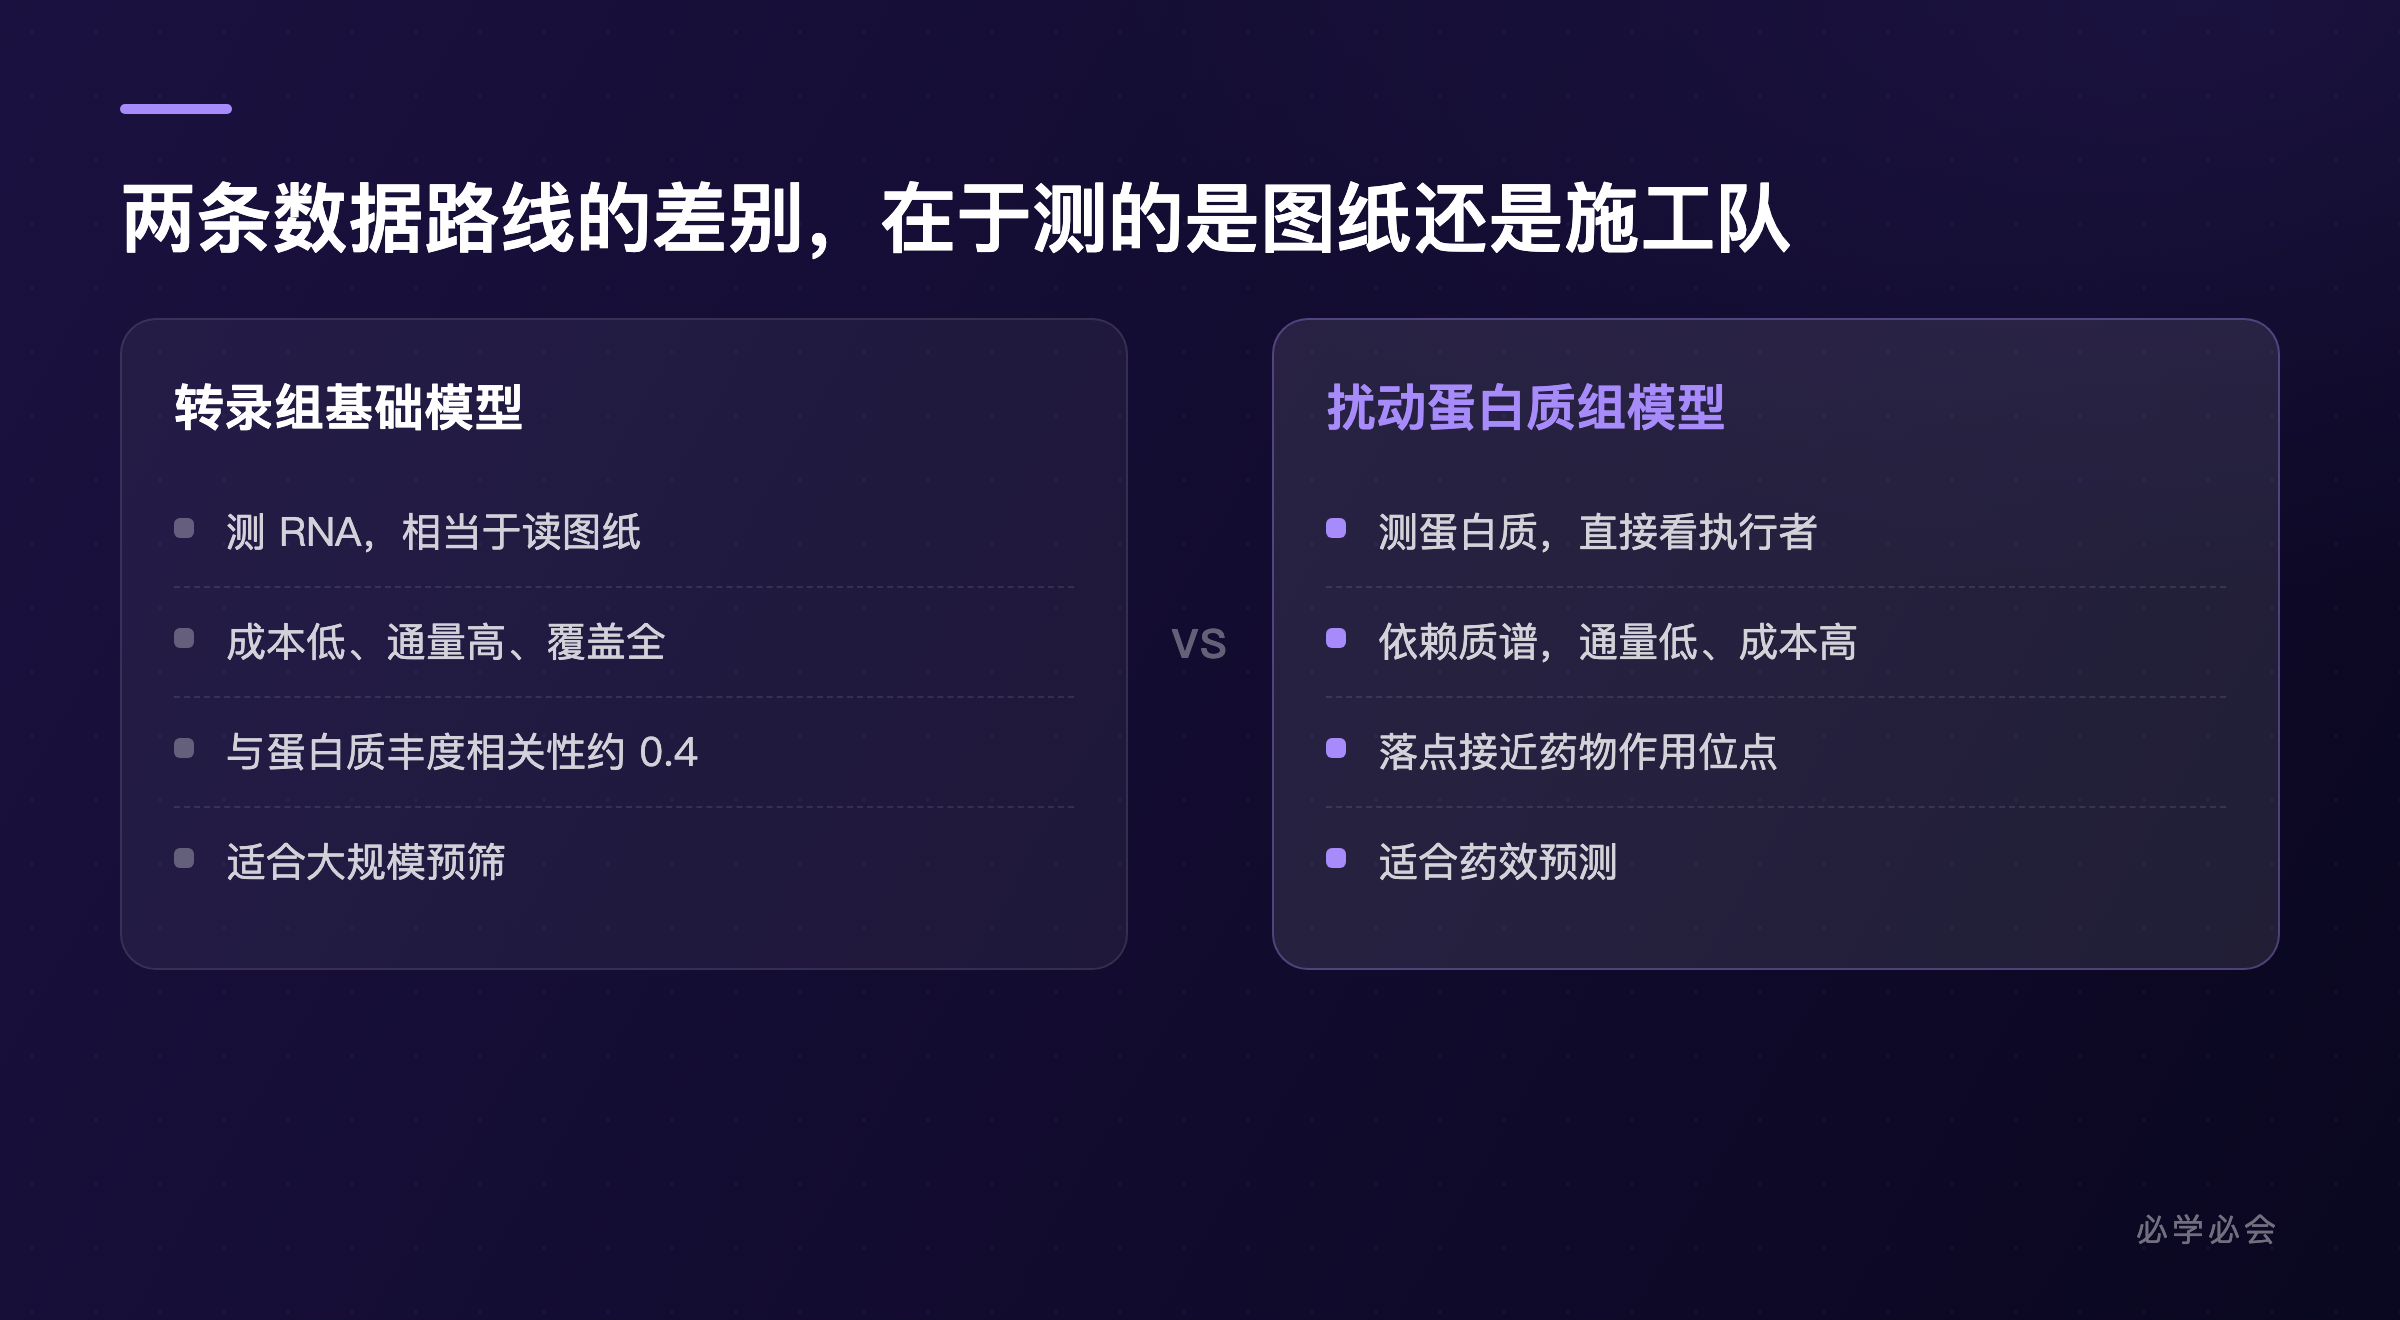
图1:两条数据路线的差别,在于测的是图纸还是施工队
判据一:测的是执行者还是说明书
药物作用的落点绝大多数在蛋白质上:抑制剂结合激酶,抗体拦住受体,降解剂把目标蛋白拖进蛋白酶体。如果训练数据只到 RNA 这一层,模型学到的是「说明书会怎么变」,而要预测的是「施工队会停在哪」。
这不是说转录组没用。它便宜、通量高、覆盖全,适合做大范围筛选。但如果终点是药效,把蛋白质作为主模态,通常更接近答案。
判据二:拍的是照片还是电影
多数公开数据是单时间点快照:给药后 24 小时测一次,或者干脆只测一个 untreated 基线。快照能看出状态差异,看不出过程。
同样是 24 小时后的蛋白丰度,可能来自「先升后降」,也可能来自「缓慢爬升」。两条完全不同的动力学曲线在同一个时间点上可以给出同一个数值。时间分辨扰动数据把照片换成电影,模型才有可能学到「这个药在什么时间尺度上起作用」。
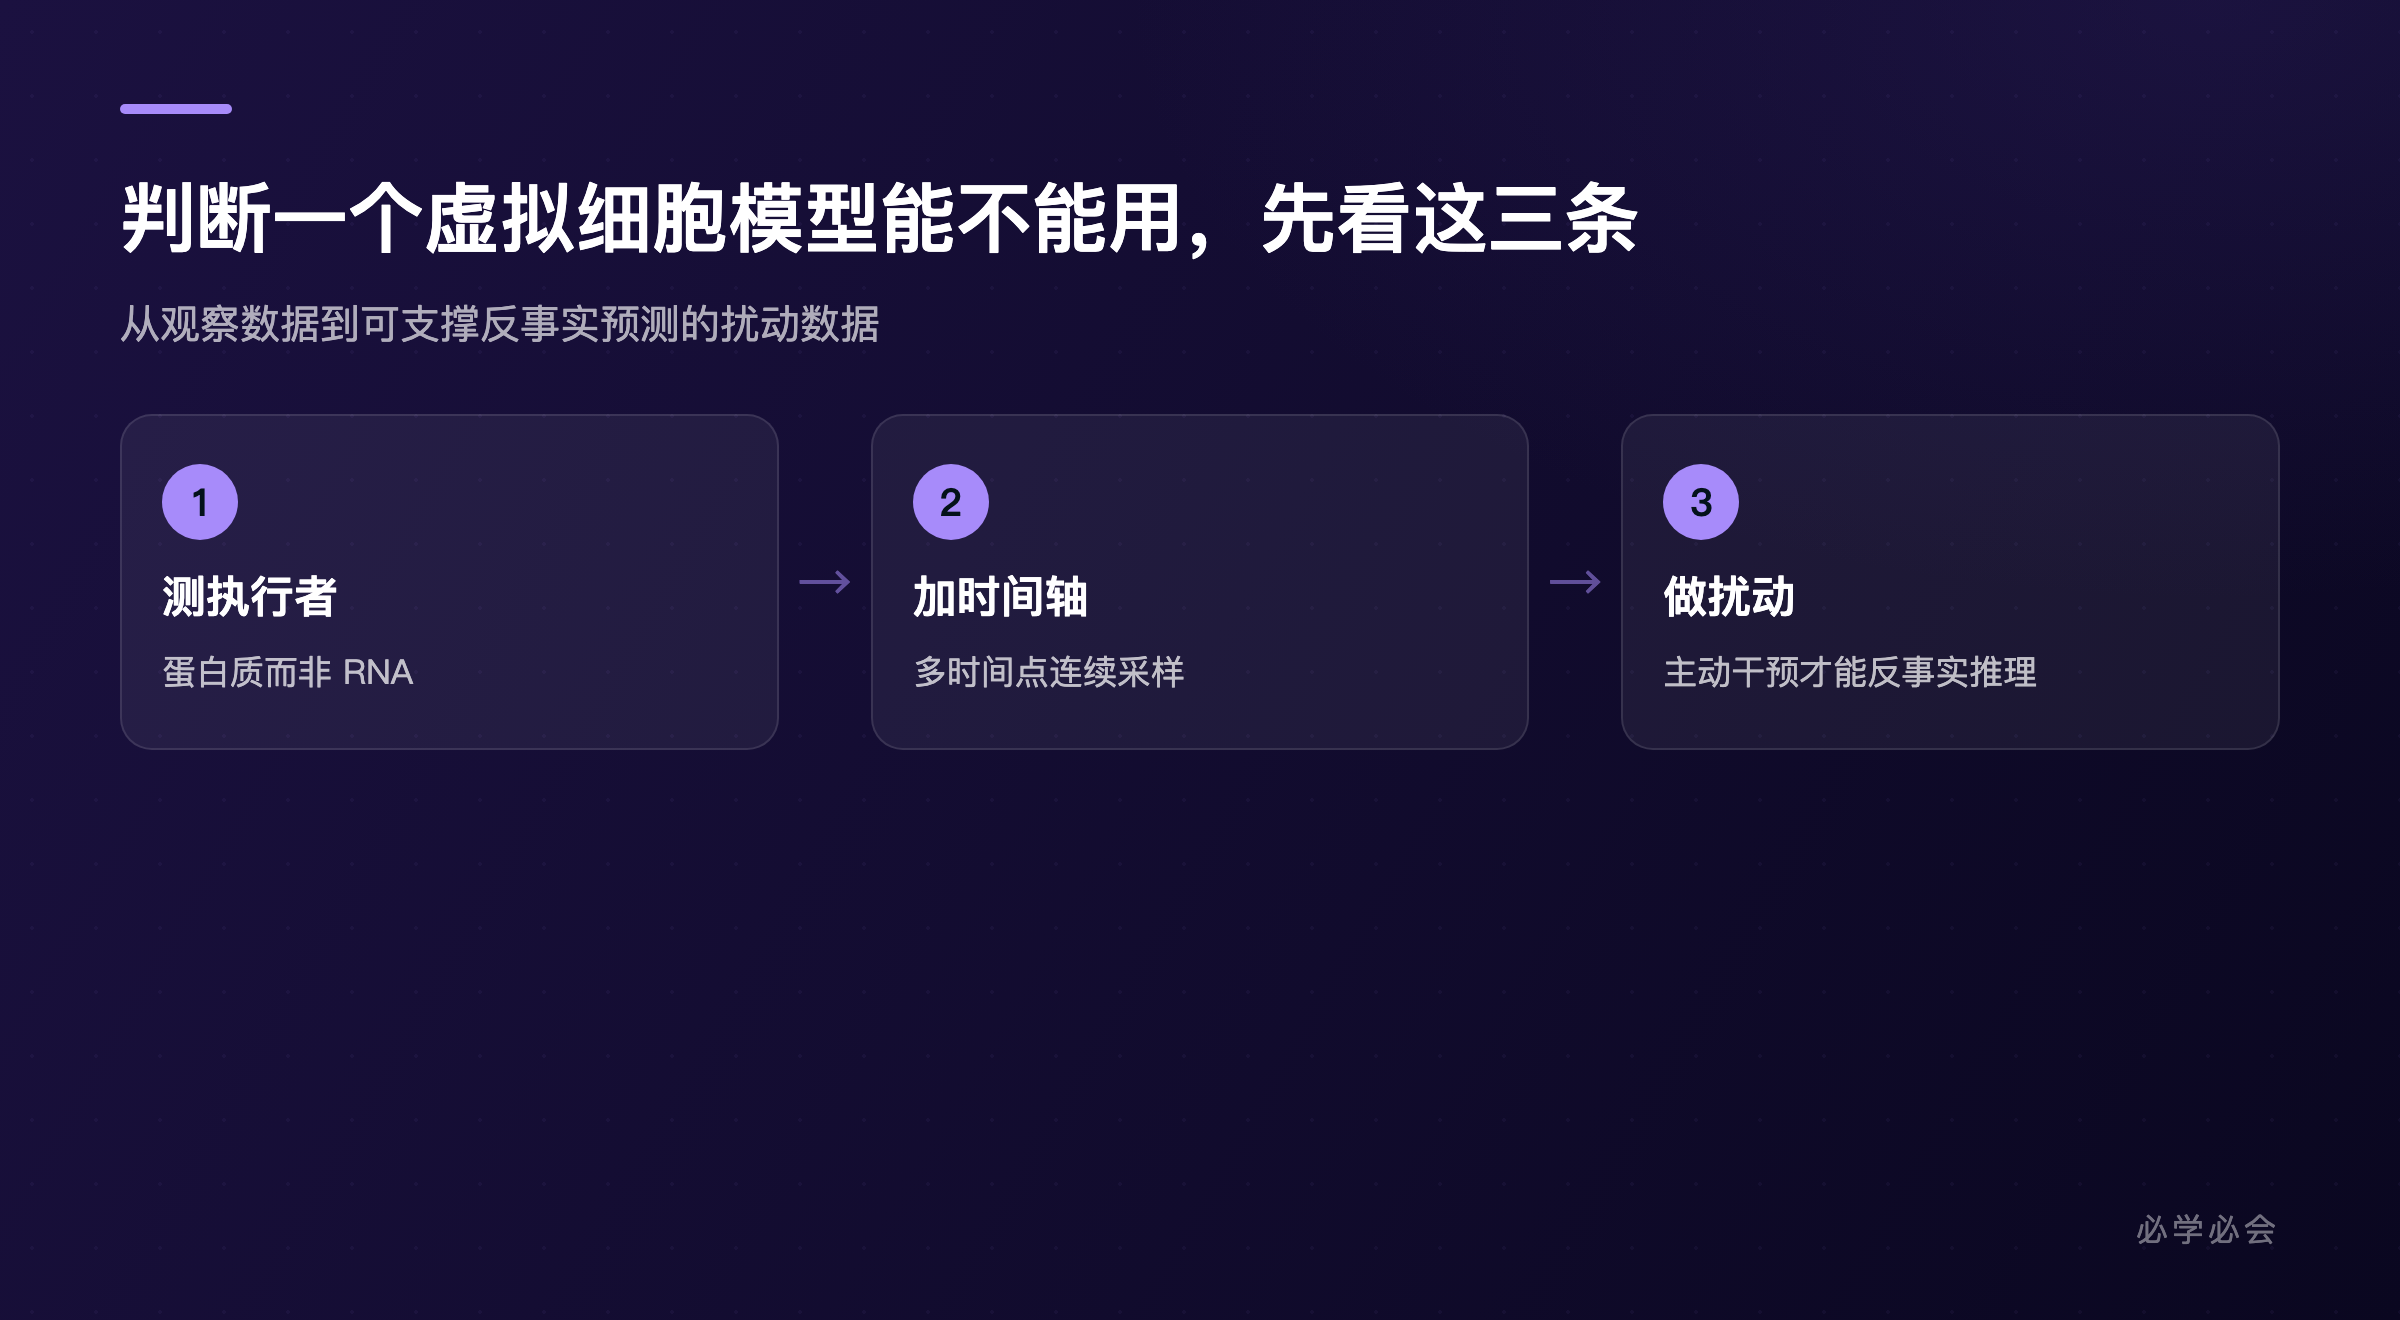
图2:判断一个虚拟细胞模型能不能用,先看这三条
判据三:观察还是干预
相关性数据回答「A 高的时候 B 也高」,干预数据回答「把 A 压下去,B 会不会跟着变」。只有后者能支撑「如果给这个病人用这个药,会怎样」这类反事实问题——而这正是虚拟细胞被期待做的事。
所以「扰动」(perturbation)是关键词。加药、敲低、过表达,任何一种主动改变都算。纯 observational 的大规模数据在预训练阶段有价值,但要拿来做预测,必须有成体系的扰动数据兜底。
核心要点
- RNA 是图纸,蛋白质是施工队;两者相关性约 0.4,不能互相替代
- 单时间点快照会丢失动力学信息,时间分辨数据才有过程
- 只有扰动数据支持反事实预测,纯观察数据做不到「如果用这个药会怎样」
- 评估标准要用临床终点(药敏、预后分层),不能只看重建误差
- 数据规模不是唯一变量,模态和实验设计往往更关键
一个反例:为什么「更大」不一定更好
近两年的主流思路是把数据规模和模型参数一起往上堆。这条路在蛋白质结构预测上跑通了,因为结构数据有一个稳定的物理约束——序列决定结构。细胞状态没有这种硬约束,同一批 RNA 在不同细胞类型里会走向不同的蛋白质分布。
于是一条更省力的路线出现了:不追求覆盖所有细胞,而是锁定一个具体临床问题(比如三阴性乳腺癌的药敏),为它专门采集时间分辨的扰动蛋白质组数据,训练一个专用模型。数据量小得多,但每一条都直接指向要预测的那个量。
怎么读一篇虚拟细胞论文
先看数据,再看模型。三个问题:测的是哪一层分子;有没有时间维度;扰动是怎么设计的。这三问答不上来,指标再漂亮也先打个问号。第二步看评估:是在独立患者样本上做的,还是只用细胞系做的;终点是临床可用的判断,还是重构误差。
模型架构反而可以最后看——这一层各家差距远没有数据层大。