从读基因到写生命:合成生物学用 30 年把测序仪变成了打字机
1977 年,桑格(Frederick Sanger)测出第一个完整的基因组序列——噬菌体 φX174,5386 个碱基。当时能做的是"读"。三十年后,人类开始认真地"写"。
1977 年,桑格(Frederick Sanger)测出第一个完整的基因组序列——噬菌体 φX174,5386 个碱基。当时能做的是"读"。三十年后,人类开始认真地"写"。
读的年代:从 5386 到 30 亿
测序成本的下跌速度长期快过摩尔定律。1990 年启动的人类基因组计划花了十三年、约三十亿美元;到 2020 年代,一份个人全基因组测序的价格已经跌到几百美元量级。读的能力不再是瓶颈之后,问题自然转向另一边:读懂了,能不能改?改好了,能不能从零写?
写的第一步:删掉三个密码子
2010 年代,剑桥与哈佛的团队把大肠杆菌基因组做了全局重编码,在近两万个位点替换序列,删掉了 64 个密码子中的 3 个,细菌仍然存活。这是当时最激进的一次改写,但框架仍是自然界现成的——相当于把一本书做了删减版,故事主线没动。
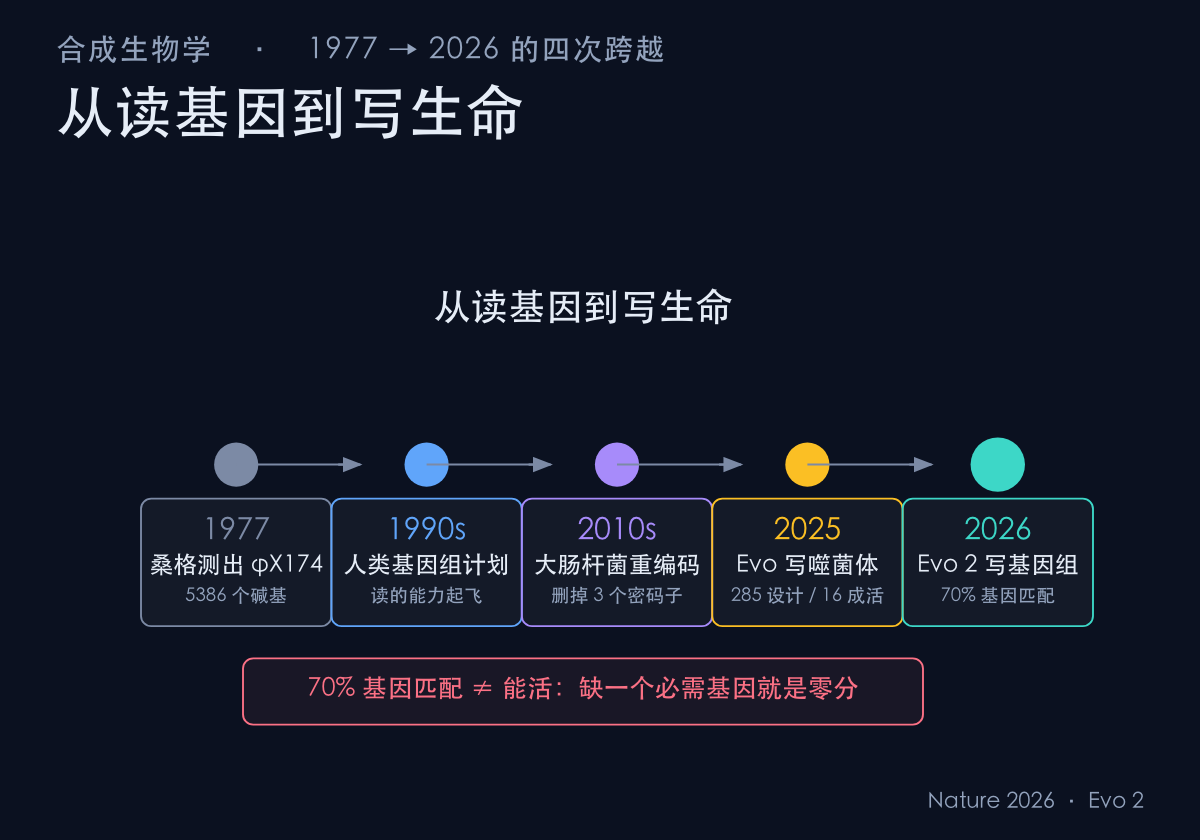
图2:1977 桑格测序 → 2010s 基因组重编码 → 2025 Evo → 2026 Evo 2
2025–2026:模型开始自己写
2024 年底发布的 Evo 是第一个在全基因组尺度、单核苷酸分辨率上生成 DNA(脱氧核糖核酸)序列的模型。2025 年,团队用它设计噬菌体基因组,285 个设计里有 16 个真的组装出了能杀细菌的病毒。这一步已经跨过了"编辑",但噬菌体只有几千个碱基,且必须依赖宿主,算不上独立生命。
2026 年,Evo 2 把尺度推到了能独立存活的最小细胞。它用约 9 万亿个碱基、覆盖生命之树上十余万个基因组做训练,上下文窗口达到一百万碱基对。给它一段生殖支原体(Mycoplasma genitalium)的序列作提示,它能续写出接近完整长度的 580 千碱基基因组,其中约七成预测基因能匹配到已知蛋白家族——Evo 1 时期这个比例约 18%。它还生成过完整的人类线粒体基因组和一段酵母染色体序列。
70% 不等于活
这里有个必须讲清的落差。一个能活的细胞要求所有必需基因齐全、顺序正确、调控元件到位,缺一个就死。计算机指标给出七成相似度,在合成生命这件事上和零分没有区别——就像操作系统 99% 的代码正确,错的那行在启动路径上,机器照样开不了机。Evo 2 到目前为止交付的是"高度合理的序列设计",不是"活细胞"。
真正的分水岭在哪里
合成生物学这三十年的转折,不在于工具变快,而在于角色换了:人从"逐段修改既有序列"变成"提出约束、让模型给方案、再用湿实验筛"。实验没有变少,只是从手工劳动变成了验证与筛选。这个分工变化,才是"读→写"真正的含义。
关联推荐
- 桑格研究所:人类基因组三分之一产自这里 — 读的年代的主力机构
- AI 共同科学家:科研从"人做"到"人机共创" — 同一场分工变化在别的领域
- 模式生物图鉴:6 种撑起现代生物学的小生命 — 写完之后要在谁身上验证
参考来源:Nature:Genome modelling and design across all domains of life with Evo 2(2026,Arc Institute / Stanford / NVIDIA);Evo 1(Science, 2024);大肠杆菌全基因组重编码相关工作。
评论 (0)
正文划词可点「问萝卜特」——自动发评论并由 AI 回复
加载评论中…